(imagen enlazada de la noticia, Corbis)
Bitácora personal de Emilio López Cano, Estadístico (Data Scientist dicen ahora). Enseñando Estadística y Matemáticas en la Universidad de Castilla-La Mancha, y Data Science en la Universidad Rey Juan Carlos. Investigando en proyectos de la Universidad Rey Juan Carlos. Contribuyendo a estándares en AENOR. Formando en la Asociación Estadística de la Calidad. Escribo sobre estos temas.
Mostrando entradas con la etiqueta Estadística. Mostrar todas las entradas
lunes, 21 de marzo de 2016
Sobre la importancia de la Estadística para la ciencia
Artículo aparecido en elconfidencial.com: Los investigadores no saben estadística (y eso perjudica a la ciencia)
Recomiendo encarecidamente la lectura de este artículo (y al que le queden ganas de alguno de los artículos científicos a los que hace referencia). Muchos de los científicos que conozco son conscientes de la importancia de la estadística, es algo que realmente les preocupa. Pero cuando llega la hora de la verdad (por el motivo que sea: falta de medios, de ganas, de apoyo, ...) la realidad es que en la mayoría de los casos se aplican "recetas" más o menos conocidas que no duelan mucho. Food for thought.
(imagen enlazada de la noticia, Corbis)
domingo, 11 de enero de 2015
Sociedad de Estadística e Investigación Operativa: inscripción gratuita para estudiantes
La Asamblea General de la Sociedad de Estadística e Investigación Operativa (SEIO) decidió el pasado 20 de Octubre que los estudiantes de máster o último año de grado pueden inscribirse en la Sociedad de forma gratuita. La inscripción da derecho a recibir la revista electrónica BEIO y el boletín INFOSEIO via mail, además de todas las comunicaciones que la SEIO realiza a sus socios. Todos los detalles para inscribirse bajo la figura de Socio Estudiante pueden consultarse en la web de la SEIO.
Como socio me parece una iniciativa extraordinaria para que las nuevas generaciones de estadísticos se vayan incorporando a esta formidable profesión.
martes, 10 de diciembre de 2013
Preparando las V Jornadas de Usuarios de R
Esta semana se celebran las V Jornadas de Usuarios de R organizadas por la Comunidad R-Hispano, asociación de usuarios de R que echó a andar oficialmente en noviembre de 2011, precisamente en el transcurso de las III Jornadas. Es una ocasión única para conocer qué se está haciendo en el mundo de R en España, y compartir un par de días con entusiastas de R.
En esta edición presentaré en conferencia plenaria el trabajo Mejora de la calidad con R: Aplicación de Seis Sigma y otros métodos estadísticos, donde muestro la relación entre Estadística y Calidad basada en tres pilares:
- Metodologías para la calidad y técnicas estadísticas relacionadas
- Herramientas disponibles en el software estadístico y lenguaje de programación R
- Las normas internacionales ISO y su proceso de elaboración
Del resto del programa hay muchas cosas interesantes. Da gusto ver en las conferencias plenarias a amigos con los que estoy trabajando de una forma u otra. También tiene buena pinta la ponencia invitada Optimización Entera Mixta No Lineal (MINLP) con R y Pyomo: Un ejemplo práctico (Jorge Ayuso Rejas). Tengo pendiente implementar Pyomo en mi nuevo paquete optimr, todavía en pañales pero que ya estamos aplicando en el proyecto EnRiMa.
domingo, 25 de noviembre de 2012
Presentación en la "nueva" Facultad de Estadística

Esta semana he tenido la oportunidad de hacer una presentación en la flamante Facultad de Estudios Estadísticos de la Universidad Complutense de Madrid. Lo de flamante, no porque sea un edificio nuevo ni mucho menos, sino porque desde el 16 de noviembre, oficialmente pasa de ser Escuela Universitaria a Facultad. Por cierto, por mucho que algunos se hayan empeñado en alargarle el nombre, supongo que al final todos la llamaremos Facultad de Estadística, para abreviar. Enhorabuena en todo caso a la Facultad y todos sus integrantes.
Esta presentación ha tenido para mí un significado especial por muchos motivos. En primer lugar, me encanta volver allí donde me formé como estadístico, sea cual sea el motivo. Especialmente después de haber sido uno de los primeros Graduados en Estadística Aplicada de España, gracias a la valentía, esfuerzo y mucho trabajo de los profesores y equipos directivos anterior y actual, que en primer año de aplicación del denostado proceso de Bolonia, implementaron el Grado en Estadística Aplicada en todos los cursos y el curso de adaptación para Diplomados en Estadística, asegurando así una rápida incorporación al nuevo sistema para todos los estudiantes (pasados, presentes y futuros) de la entonces Escuela Universitaria de Estadística. Además, iba invitado por María Villeta, profesora de la asignatura Metodología Seis Sigma para la Mejora de la Calidad, que me empeñé en elegir como optativa cuando en marzo del año 2010 me matriculé en el curso de adaptación al Grado para diplomados a pesar de las dificultades, que no vienen a cuento aquí. Algo me decía que la asignatura me iba a aportar mucho en el futuro, como así ha sido, y con el apoyo y ánimo de María se encendió la chispa de mi posterior "especialización" en el tema.
La Presentación
La presentación era sobre el libro Six Sigma with R, publicado por Springer y del que soy coautor junto con Javier M. Moguerza y Andrés Redchuk, que tutorizaron mi Proyecto fin de Master en la Universidad Rey Juan Carlos, donde ahora trabajo como investigador mientras realizo el doctorado. Ya he hablado de mi interés en Six Sigma; sobre la segunda parte del título del libro (with R) más que interés es pasión. Desde que empecé a utilizar R y tras las primeras dificultades del autodidacta en R, lo fui dominando (o viceversa) y hoy en día hago todo lo que puedo con R (los R adictos sabemos que con R se puede hacer de todo, incluso encargar pizza).En la charla, tras presentar a los autores y explicar la génesis del libro, traté de hacer un recorrido por los contenidos con las citas de diversos personajes con la que iniciamos cada capítulo, para después hacer algunas reflexiones sobre las oportunidades de lo que viene llamándose Data Science, y de R. Espero que gustara a la audiencia, a la que agradezco su asistencia. Entre los asistentes se encontraba otro de los "inspiradores" de mi trabajo, Mariano Prieto, profesor de la asignatura Calidad Seis Sigma en el Master Universitario en Ingeniería de Sistemas de Decisión. También había alumnos del grado, así como profesores de la Facultad, espero que todos disfrutaran. Me consta que un profesor entusiasta de R, al que le mando saludos y aliento, no pudo asistir a su pesar. Ojalá contemos con él en el próximo congreso internacional de R que se celebrará en España, y tenga la oportunidad de conocerle en persona.
martes, 3 de julio de 2012
Año Internacional de la Estadística (Statistics2013)
El próximo año estamos de celebración. En todo el mundo se celebrará y reconocerá las contribuciones de la Estadística. Se promocionará la importancia de la Estadística a una amplia gama de destinatarios: comunidad científica, usarios de datos del sector público y privado, medios de comunicación, legisladores, trabajadores, estudiantes y público en general (vamos, a todo el mundo). Toda la información está disponible en la web http://www.statistics2013.org.
Hay una lista de actividades alrededor del mundo relacionadas con la estadística, que imagino irá creciendo en los próximos meses. Se pueden añadir actividades sin que ello comporte compromiso alguno. Es una forma de indicar que se apoyan los objetivos del Año Internacional de la Estadística. Pronto aparecerá el próximo Congreso Internacional de Usuarios de R (useR! 2013) que se celebrará en España en este año tan especial.
Ojalá esta celebración sirva para que se conozca mejor la labor de los estadísticos, y las contribuciones tanto a la vida cotidiana como a la investigación científica.
martes, 1 de noviembre de 2011
R 2.14.0 Funcionando en Arquitect
Un día después de que Peter Dalgard anunciara la publicación de la versión 2.14.0 de R, ya la tengo a pleno rendimiento en mi equipo. Los binarios para Windows están disponibles en CRAN, y la instalación no tiene ninguna complicación, como en versiones anteriores. Personalmente, lo único que hago es cambiar el directorio de instalación a C:\R, donde tengo todas las versiones y el resto de software que necesito para utilizar R.
Tengo que decir que no sólo utilizo R para realizar análisis estadísticos. También estoy desarrollando el paquete SixSigma (disponible en CRAN) con funciones para aplicar esta metodología de mejora de la calidad. No sólo eso: Soy coautor del libro Six Sigma with R, de próxima aparición en la serie Use R! de Springer. Y estoy escribiendo el libro con R.
Como podéis imaginar, el libro contiene cantidad de código, resultados y gráficos en R. Las plantillas de Springer están en LaTex. Por tanto la mejor forma de producir el libro es utilizar archivos archivos *.Rnw y Sweave. Además de tener el libro en cada compilación en el formato adecuado para la editorial, aprovecho todas las ventajas de la "Investigación reproducible". Si tengo que hacer algún cambio en cualquier pedazo de código (chunk) no tengo que preocuparme de volver a maquetar pues los resultados se vuelven a generar en el propio libro automáticamente.
Pero todo esto es farragoso si no contamos con un entorno donde escribir R y LaTeX de forma productiva. Aquí es donde tengo que agradecer a Tobias Verbeke (OpenAnalytics) y Stephan Wahlbrink (WalWare) su trabajo con Architect y StatET respectivamente. Implementado en Eclipse, y con un aprendizaje muy rápido, para mí es la mejor opción para ganar en productividad (y lo digo después de haber utilizado otras opciones como Emacs). En todo caso, la grandeza del software libre es que cada uno puede elegir lo que más le convenga.
Mi punto de entrada hasta llegar a estas conclusiones fue una entrada en R-Bloggers, para quien se anime:
http://www.r-bloggers.com/getting-started-with-sweave-r-latex-eclipse-statet-texlipse/
NOTA: aunque Architect está disponible como instalable para Windows, la implementación de StatET en Linux no tiene dificultad siguiendo las instrucciones de instalación.
Tengo que decir que no sólo utilizo R para realizar análisis estadísticos. También estoy desarrollando el paquete SixSigma (disponible en CRAN) con funciones para aplicar esta metodología de mejora de la calidad. No sólo eso: Soy coautor del libro Six Sigma with R, de próxima aparición en la serie Use R! de Springer. Y estoy escribiendo el libro con R.
Como podéis imaginar, el libro contiene cantidad de código, resultados y gráficos en R. Las plantillas de Springer están en LaTex. Por tanto la mejor forma de producir el libro es utilizar archivos archivos *.Rnw y Sweave. Además de tener el libro en cada compilación en el formato adecuado para la editorial, aprovecho todas las ventajas de la "Investigación reproducible". Si tengo que hacer algún cambio en cualquier pedazo de código (chunk) no tengo que preocuparme de volver a maquetar pues los resultados se vuelven a generar en el propio libro automáticamente.
Pero todo esto es farragoso si no contamos con un entorno donde escribir R y LaTeX de forma productiva. Aquí es donde tengo que agradecer a Tobias Verbeke (OpenAnalytics) y Stephan Wahlbrink (WalWare) su trabajo con Architect y StatET respectivamente. Implementado en Eclipse, y con un aprendizaje muy rápido, para mí es la mejor opción para ganar en productividad (y lo digo después de haber utilizado otras opciones como Emacs). En todo caso, la grandeza del software libre es que cada uno puede elegir lo que más le convenga.
Mi punto de entrada hasta llegar a estas conclusiones fue una entrada en R-Bloggers, para quien se anime:
http://www.r-bloggers.com/getting-started-with-sweave-r-latex-eclipse-statet-texlipse/
NOTA: aunque Architect está disponible como instalable para Windows, la implementación de StatET en Linux no tiene dificultad siguiendo las instrucciones de instalación.
martes, 23 de agosto de 2011
Mi experiencia en el congreso Use R! 2011
Ya recuperado de un viaje un poco pesado, quiero mostrar lo satisfecho que estoy de haber asistido al Congreso de Usuarios de R (Use R! 2001) que un año más se ha llevado a cabo con el auspicio de la R Foundation for Statistical Computing. El departamento de Estadística de The University of Warwick en Coventry (UK) ha llevado a cabo una organización impecable, tanto por los medios a disposición de los asistentes, como el desarrollo del programa. Desde las ponencias invitadas, hasta las ordinarias, e inlcuso introduciendo un formato novedoso, las "Lightning Talks".
Los que utilizamos el alojamiento de la Universidad comprobamos lo eficientes que son, el campus en su conjunto es una maravilla. Y la cena del congreso fue un total éxito.
Escuchar a (y en algún caso incluso tener la ocasión de charlar un rato con) algunos de los gurús de R es algo que no tiene precio. Brian Ripley, Ulrike Groemping, Ramón Díaz-Uriarte, Heather Turner o Paul Murrel son solo algunos de los nombres que se dieron cita en el congreso. La organización puso en marcha un grupo en Facebook (aunque se puso en marcha una vez comenzado) y una buena colección de fotografías está disponible en la web del congreso.
En cuanto al programa ordinario, era tan amplio que era difícil decidir a qué sesión paralela (a veces había hasta CINCO) asistir. Yo me decanté más por las dedicadas a programación, gráficos y análisis de datos, y confío en poder descargar algunas de las presentaciones de las charlas a las que no pude acudir.
Mi contribución fue una presentación titulada "Six Sigma Quality Using R: Tools and Training" y una "Lightning Talk" sobre el mismo tema, ambas disponibles en los siguientes enlaces:
http://www.proyectum.es/pub/user11/LightningTalk-slidesk.pdf
http://www.proyectum.es/pub/user11/RegularTalk-Slides-w.pdf
Forma parte de nuestro trabajo en el Departamento de Estadística e Investigación Operativa en la Universidad Rey Juan Carlos de Madrid, que incluye un libro para la serie Use R! de Springer, y una propuesta de Proyecto Europeo.
Los que utilizamos el alojamiento de la Universidad comprobamos lo eficientes que son, el campus en su conjunto es una maravilla. Y la cena del congreso fue un total éxito.
Escuchar a (y en algún caso incluso tener la ocasión de charlar un rato con) algunos de los gurús de R es algo que no tiene precio. Brian Ripley, Ulrike Groemping, Ramón Díaz-Uriarte, Heather Turner o Paul Murrel son solo algunos de los nombres que se dieron cita en el congreso. La organización puso en marcha un grupo en Facebook (aunque se puso en marcha una vez comenzado) y una buena colección de fotografías está disponible en la web del congreso.
En cuanto al programa ordinario, era tan amplio que era difícil decidir a qué sesión paralela (a veces había hasta CINCO) asistir. Yo me decanté más por las dedicadas a programación, gráficos y análisis de datos, y confío en poder descargar algunas de las presentaciones de las charlas a las que no pude acudir.
Mi contribución fue una presentación titulada "Six Sigma Quality Using R: Tools and Training" y una "Lightning Talk" sobre el mismo tema, ambas disponibles en los siguientes enlaces:
http://www.proyectum.es/pub/user11/LightningTalk-slidesk.pdf
http://www.proyectum.es/pub/user11/RegularTalk-Slides-w.pdf
Forma parte de nuestro trabajo en el Departamento de Estadística e Investigación Operativa en la Universidad Rey Juan Carlos de Madrid, que incluye un libro para la serie Use R! de Springer, y una propuesta de Proyecto Europeo.
viernes, 18 de marzo de 2011
Lectura recomendada: La Conquista del Azar
La teoría de probabilidades
Ha caído otro de la colección El Mundo es Matemático, con multitud de ejemplos de la vida real, donde Fernando Corbalán y Gerardo Sanz repasan la historia de la probabilidad y sus conceptos principales, para después pasar a las curiosidades y principales aplicaciones, como loterías y tablas de vida.
Una de las sorprendentes curiosidades relatadas es el "problema de Monty Hall", que se puede simular en http://nlvm.usu.edu (http://nlvm.usu.edu/en/nav/frames_asid_117_g_3_t_5.html?from=topic_t_5.html) (citado en el libro) También se pueden simular muchas otras situaciones relacionadas con la probabilidad, como el lanzamiento de una moneda.
Texto de la contraportada:
La domesticación del azar -su reducción a números- es uno de los logros más formidables del intelecto humano. Donde antes sólo había el blanco de la certeza absoluta y el negro de la duda radical, ahora se nos abre un paisaje de infinitas gamas de gris, de probabilidades más o menos favorables, cuyo estudio y análisis constituye una de las ramas más fascinantes de la matemática moderna.
viernes, 21 de enero de 2011
Estadística divertida
Visto en:
http://usalbiomedica.wordpress.com/2011/01/21/%C2%BFquien-ha-dicho-que-la-estadistica-es-aburrida/
Me ha encantado descubrir la labor de este profesor sueco, con unos vídeos muy buenos sobre estadística. El video completo está aquí:
http://www.gapminder.org/videos/the-joy-of-stats/
Hay un extracto en Youtube:
http://usalbiomedica.wordpress.com/2011/01/21/%C2%BFquien-ha-dicho-que-la-estadistica-es-aburrida/
Me ha encantado descubrir la labor de este profesor sueco, con unos vídeos muy buenos sobre estadística. El video completo está aquí:
http://www.gapminder.org/videos/the-joy-of-stats/
Hay un extracto en Youtube:
Toda la página de Hans Rosling promete, bucearé en ella en cuanto tenga tiempo:
jueves, 9 de diciembre de 2010
Minería de Datos y Estadística Sexy
| Imagen de www.dataspora.com |
The three sexy skills of data geeks
Está escrito por Michael E. Driscoll en Dataspora Blog, sobre "Big Data, open source analytics, and data visualization".
Resumiendo, las cualidades sexy son:
- Aprender estadística
- Sufrir el Data Munging (sic)
- Contárselo a alguien (visualización)
Termina diciendo que con las tres cualidades juntas, somos sexy.
En esta entrada y en otra de Barrapunto he visto también enlaces a tres libros sobre sobre Data Mining disponibles para descargar, y que reproduzco aquí:
Por cierto no busquéis munging en los diccionarios, que no está. Yo lo traduciría libremente como Masticar los datos, y hay varias referencias por ahí:
- Hay un libro de Manning titulado "Data Munging with Perl", donde dice que " 'munging' is a common term in the programmer's world. Many computing tasks require taking data from one computer system, manipulating it in some way, and passing it to another. Munging can mean manipulating raw data to achieve a final form. It can mean parsing or filtering data, or the many steps required for data recognition"
- En el propio artículo de Driscoll, dice que " this refers to the painful process of cleaning, parsing, and proofing one’s data before it’s suitable for analysis"
sábado, 27 de noviembre de 2010
Primer Congreso de Jóvenes Investigadores en Estadística
Esta semana he tenido la suerte de participar en el Primer Congreso de Jóvenes Investigadores en Estadística. Aunque no he presentado ningún trabajo por falta de tiempo, me ha sido muy útil por varias razones.
La primera, el haber conocido a una serie de profesionales del más alto nivel en la investigación en Bioestadística y Diseño de Experimentos, tanto de España como de fuera de España. Además, he conocido más de cerca cómo funciona el mundo de la Investigación, al que intento acercarme día a día para encontrar mi hueco. Y por último, he conocido algunos trabajos del más alto nivel en el área del Diseño Óptimo de Experimentos, y de la Bioestadística.
Como dijo Raúl Martín, presidente del Comité Científico Organizador, espero que haya un Segundo Congreso, y el devenir de los acontecimientos me permita acudir y presentar alguno de mis trabajos.
El congreso en los medios:
http://www.lacerca.com/noticias/universidad/escuela_arquitectura_jovenes_investigadores-72317-1.html
http://dclm.es/news/172/ARTICLE/82255/2010-11-25.html
http://www.uclm.es/gabinete/ver_noticias.asp?id_noticia=7754
La primera, el haber conocido a una serie de profesionales del más alto nivel en la investigación en Bioestadística y Diseño de Experimentos, tanto de España como de fuera de España. Además, he conocido más de cerca cómo funciona el mundo de la Investigación, al que intento acercarme día a día para encontrar mi hueco. Y por último, he conocido algunos trabajos del más alto nivel en el área del Diseño Óptimo de Experimentos, y de la Bioestadística.
Como dijo Raúl Martín, presidente del Comité Científico Organizador, espero que haya un Segundo Congreso, y el devenir de los acontecimientos me permita acudir y presentar alguno de mis trabajos.
El congreso en los medios:
http://www.lacerca.com/noticias/universidad/escuela_arquitectura_jovenes_investigadores-72317-1.html
http://dclm.es/news/172/ARTICLE/82255/2010-11-25.html
http://www.uclm.es/gabinete/ver_noticias.asp?id_noticia=7754
viernes, 17 de septiembre de 2010
La noche de los investigadores en Madrid
El día 24 de septiembre, se celebra en Madrid el evento "La Noche de los Investigadores", con el lema "Creatividad para el avance de Europa". Un total de 18 actividades, entre ellas Trivial de Estadística que organiza la Universidad Carlos III de Madrid.
Algunos enlaces con información:
http://www.uc3m.es/portal/page/portal/actualidad_cientifica/publi/noche_investigadores
http://www.madrimasd.org/lanochedelosinvestigadores/
http://www.facebook.com/madrimasd#!/event.php?eid=138609226165382&index=1
Si estuviera en Madrid ese día, sin duda asistiría a varias de las actividades.
Algunos enlaces con información:
http://www.uc3m.es/portal/page/portal/actualidad_cientifica/publi/noche_investigadores
http://www.madrimasd.org/lanochedelosinvestigadores/
http://www.facebook.com/madrimasd#!/event.php?eid=138609226165382&index=1
Si estuviera en Madrid ese día, sin duda asistiría a varias de las actividades.
miércoles, 30 de junio de 2010
Seminario Técnicas Avanzadas de Investigación
Del 1 al 4 de junio de 2010, he asistido a un interesante seminario sobre Técnicas Avanzadas de Investigación, en la Facultad de Ciencias Económicas de la Universidad de Castilla la Mancha en Albacete, dirigido por el Catedrático Juan J. Jiménez Moreno.
El seminario ha estado a cargo de Ana Mª Legato, profesora de la Universidad Nacional del Centro de Buenos Aires. Las explicaciones de Ana han sido claras y amenas, la documentación muy completa y útil, y salvo un pequeño problema informático (siempre los hay) con una de las prácticas, para mí el seminario fue muy satisfactorio.
Los temas abordados en esta edición, ha sido Regresión PLS, Modelos de Ecuaciones Estructurales, y el Modelo Logístico. Los dos primeros se vieron con mayor profundidad.
Ya aparece en la web del profesor Jiménez la siguiente edición (y van 13) del seminario, al que asistiré si no me lo impiden otros compromisos, ya que cada año se tratan temas diferentes y actuales.
lunes, 7 de junio de 2010
Estadística Espacial
El pasado 28 de mayo tuve la oportunidad de asistir a una charla organizada por la Escuela Politécnica de Albacete de la UCLM, en el marco del curso propio de Especialista en análisis de datos.
Agradezco la invitación que me hicieron, y me gustó mucho la explicación de Lola Ugarte, sobre Modelización espacio-temporal de la mortalidad con splines penalizados, técnica que están utilizando en el grupo de investigación al que pertenece de Estadística Espacial.
Esta "rama" de la estadística, que intenta explicar los datos desde la dimensión espacial, se puede aplicar a cualquier investigación, ya que todo dato se genera en algún "sitio", y está poniéndose muy en boga ya que tenerlo en cuenta o no tenerlo en cuenta, puede variar el resultado de una investigación, y por otra parte los resultados son más ricos.
En cuanto a la modelización con splines penalizados, aconsejo leer su trabajo de investigación para más detalles, y comprobar cómo llega a aproximar un modelo lineal más "accesible" a partir del inicial dinámico y no lineal:
Agradezco la invitación que me hicieron, y me gustó mucho la explicación de Lola Ugarte, sobre Modelización espacio-temporal de la mortalidad con splines penalizados, técnica que están utilizando en el grupo de investigación al que pertenece de Estadística Espacial.
Esta "rama" de la estadística, que intenta explicar los datos desde la dimensión espacial, se puede aplicar a cualquier investigación, ya que todo dato se genera en algún "sitio", y está poniéndose muy en boga ya que tenerlo en cuenta o no tenerlo en cuenta, puede variar el resultado de una investigación, y por otra parte los resultados son más ricos.
En cuanto a la modelización con splines penalizados, aconsejo leer su trabajo de investigación para más detalles, y comprobar cómo llega a aproximar un modelo lineal más "accesible" a partir del inicial dinámico y no lineal:
"Spatio-temporal modelling of mortality risks using penalized splines". Environmetrics, 21, pp. 270-289 (2010). Autores: Ugarte, M. D., Goicoa, T.and Militino A. F.También muy recomendable su libro sobre R
miércoles, 5 de mayo de 2010
Control de Calidad con R: Muestreos de Aceptación
Para el diseño y verificación de muestreos de aceptación, disponemos en R del paquete AcceptanceSampling.
Uso del paquete AcceptanceSampling
Muestreo simple
Primero tenemos que cargar la librería, en el intérprete de comandos, o alguna de las interfaces gráficas (RCommander o RKWard):
> library(AcceptanceSampling)
Crear un plan de muestreo (ejemplo: n=300, c=5, distribución binomial):
> x <- OC2c(300, 5, type="b")
Mostrar el plan de muestreo:
> x
Mostrar el plan de muestreo detallado (muchos puntos OC):
> summary(x, full=TRUE)
Mostrar gráfico de la curva OC:
> plot(x, xlim = c(0, 0.3))
Encontrar un plan, dada OC (alfa=0.05, p1=0.05, beta=0.15, p2=0.10, distribución binomial):
> find.plan(PRP = c(0.05, 0.95), CRP = c(0.15, 0.10), type = "binom")
Muestreo doble y múltiple
Se procede igual que para el muestreo simple, pero indicando los valores de n, c y r como vectores:
> x <- OC2c(n=c(50, 100), c=c(0, 1), r=(2, 2))
Otros recursos
En la siguiente página se pueden calcular automáticamente muestreos de aceptación utilizando las normas MIL-STD y otras:
www.sqconline.com/
Gracias por el aporte María.
Paquete AcceptanceSampling
Disponible para instalar de los repositorios
Artículo en Journal of Statistical Software
Uso del paquete AcceptanceSampling
Muestreo simple
Primero tenemos que cargar la librería, en el intérprete de comandos, o alguna de las interfaces gráficas (RCommander o RKWard):
> library(AcceptanceSampling)
Crear un plan de muestreo (ejemplo: n=300, c=5, distribución binomial):
> x <- OC2c(300, 5, type="b")
Mostrar el plan de muestreo:
> x
Mostrar el plan de muestreo detallado (muchos puntos OC):
> summary(x, full=TRUE)
Mostrar gráfico de la curva OC:
> plot(x, xlim = c(0, 0.3))
Encontrar un plan, dada OC (alfa=0.05, p1=0.05, beta=0.15, p2=0.10, distribución binomial):
> find.plan(PRP = c(0.05, 0.95), CRP = c(0.15, 0.10), type = "binom")
Muestreo doble y múltiple
Se procede igual que para el muestreo simple, pero indicando los valores de n, c y r como vectores:
> x <- OC2c(n=c(50, 100), c=c(0, 1), r=(2, 2))
Otros recursos
En la siguiente página se pueden calcular automáticamente muestreos de aceptación utilizando las normas MIL-STD y otras:
www.sqconline.com/
Gracias por el aporte María.
martes, 4 de mayo de 2010
Redes Neuronales con R
Introducción
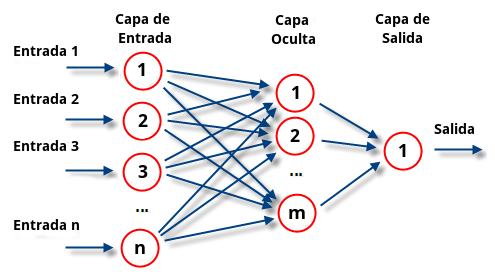
Para empezar, existen distintos modelos de redes neuronales, siendo uno de los más utilizados el del "Perceptron".
Esta red se basa en una "caja negra", donde lo importante es la predicción, y no cómo se hace.
El proceso incluye una fase de entrenamiento (training) para la optimización de las predicciones.
Los elementos de la red son:
Una descripción "grosso modo" podría ser: Los nodos (neuronas) de la capa de entrada, se combinan con los nodos de la capa oculta mediante la función de combinación, que suele ser una combinación lineal de los nodos de entrada mediante los pesos. A las neuronas de las capas ocultas, se aplica una función de activación, que suele ser la tangente hiperbólica de la anterior combinación más un parámetro por nodo oculto, con la que estimamos las neuronas de la capa de salida, y sus errores.
Recursos:
En Wikipedia: RNA, Perceptrón.
En este documento de la Universidad Carlos III de Madrid hay una introducción bastante bien explicada, con ejemplos en R:
Introducción a las redes neuronales aplicadas uc3m)
Paquete nnet
Se puede instalar desde los repositorios
Documentación
Paquete RWeka
Se puede instalar desde los repositorios
Documentación
Paquete neural
Documentación
neural no está en los repositorios, para instalar:
Paquete AMORE
Se puede instalar desde los repositorios. Es un paquete desarrollado en la Universidad de León, con abundante documentación.
Documentación
Wiki
Ejemplo
Próximamente
Para empezar, existen distintos modelos de redes neuronales, siendo uno de los más utilizados el del "Perceptron".
Esta red se basa en una "caja negra", donde lo importante es la predicción, y no cómo se hace.
El proceso incluye una fase de entrenamiento (training) para la optimización de las predicciones.
Los elementos de la red son:
- Las neuronas o nodos
- Las capas
- De entrada
- De salida
- Oculta (puede tener a su vez varias capas)
- Los pesos
- La función de combinación
- La función de activación
- El objetivo (target)
Una descripción "grosso modo" podría ser: Los nodos (neuronas) de la capa de entrada, se combinan con los nodos de la capa oculta mediante la función de combinación, que suele ser una combinación lineal de los nodos de entrada mediante los pesos. A las neuronas de las capas ocultas, se aplica una función de activación, que suele ser la tangente hiperbólica de la anterior combinación más un parámetro por nodo oculto, con la que estimamos las neuronas de la capa de salida, y sus errores.
Recursos:
En Wikipedia: RNA, Perceptrón.
En este documento de la Universidad Carlos III de Madrid hay una introducción bastante bien explicada, con ejemplos en R:
Introducción a las redes neuronales aplicadas uc3m)
Paquete nnet
Se puede instalar desde los repositorios
Documentación
Paquete RWeka
Se puede instalar desde los repositorios
Documentación
Paquete neural
Documentación
neural no está en los repositorios, para instalar:
- Descargar de http://cran.r-project.org/src/contrib/Archive/neural/
- Instalar desde ubicación local
Paquete AMORE
Se puede instalar desde los repositorios. Es un paquete desarrollado en la Universidad de León, con abundante documentación.
Documentación
Wiki
Ejemplo
Próximamente
Paquete estadístico "R": Uso de Rcommander
Notas
">" : Ejecutar desde el intérprete de comandos de R
"~$": Ejecutar en la consola de Linux
Para instalar:
~$ sudo R
> install.packages("Rcmdr", dependencies=TRUE)
Para iniciar desde la consola:
~$ R
> library(Rcmdr)
Para iniciar desde la consola cuando ya hemos cerrado Rcmdr:
> Commander()
En Windows
Se puede arrancar también desde la consola de R, pero para evitar errores tenemos que abrir R en modoSDI . Si no elegimos esta opción al instalar R, podemos forzar este tipo de ejecución, añadiendo al comando del acceso directo que abre la aplicación la opción --r (Propiedades del acceso directo, caja de texto "Destino", quedaría algo así: "C:\Program Files\R\R-2.11.0\bin\Rgui.exe" --sdi
">" : Ejecutar desde el intérprete de comandos de R
"~$": Ejecutar en la consola de Linux
Para instalar:
~$ sudo R
> install.packages("Rcmdr", dependencies=TRUE)
Para iniciar desde la consola:
~$ R
> library(Rcmdr)
Para iniciar desde la consola cuando ya hemos cerrado Rcmdr:
> Commander()
En Windows
Se puede arrancar también desde la consola de R, pero para evitar errores tenemos que abrir R en modo
sábado, 1 de mayo de 2010
La Estadística, "sexy job" para los próximos 10 años, según Google
Esta es una de las afirmaciones que se hacen en un artículo del New York Times, nada menos que por el economista jefe de Google:
La propia IBM ha creado un grupo de análisis y optimización, contratanto a más de 200 analistas (matemáticos, estadísticos, ...) y tienen previsto contar con más de 4.000 en toda la compañía.
Pues nada, a ver si es verdad.
Enlaces:
http://www.nytimes.com/2009/08/06/technology/06stats.html?_r=2
http://www.newser.com/story/66223/todays-sexy-job-statistician.html
http://www.conversion-rate-experts.com/the-datarati/
NOTA: el artículo del NYT es de agosto del 2009, pero como los americanos nos llevan varios años de adelanto en estos temas, tiene absoluta vigencia.
"I keep saying that the sexy job in the next 10 years will be statisticians,” said Hal Varian, chief economist at Google. “And I’m not kidding".Según otro economista, del MIT, el reto es la capacidad de los humanos para usar, analizar, y dar sentido a los datos, en un mundo en que todo puede ser medido y monitorizado.
Los Datos son simplemente el material en bruto del conocimiento.
La propia IBM ha creado un grupo de análisis y optimización, contratanto a más de 200 analistas (matemáticos, estadísticos, ...) y tienen previsto contar con más de 4.000 en toda la compañía.
Pues nada, a ver si es verdad.
Enlaces:
http://www.nytimes.com/2009/08/06/technology/06stats.html?_r=2
http://www.newser.com/story/66223/todays-sexy-job-statistician.html
http://www.conversion-rate-experts.com/the-datarati/
NOTA: el artículo del NYT es de agosto del 2009, pero como los americanos nos llevan varios años de adelanto en estos temas, tiene absoluta vigencia.
viernes, 30 de abril de 2010
Paquete estadístico "R": Uso de la consola
Convenciones
> Ejecutar en la consola de R
~$ Ejecutar en la consola de Linux
cursiva Identificador variable
Arrancar la consola
~$ R
Arrancar la consola con derechos de superusuario (para instalación)
~$ sudo R
Instalar paquete descargado
> install.packages ("ruta archivo .gz")
Instalar paquete de repositorios
> install.packages ("paquete", dependencies=TRUE)
Exportar gráfico generado
Antes de ejecutar el gráfico, debemos dar la instrucción con el tipo de gráfico que queremos guardar:
> jpeg("archivo.jpg")
Después ejecutamos el gráfico, por ejemplo:
> Ejecutar en la consola de R
~$ Ejecutar en la consola de Linux
cursiva Identificador variable
Arrancar la consola
~$ R
Arrancar la consola con derechos de superusuario (para instalación)
~$ sudo R
Instalar paquete descargado
> install.packages ("ruta archivo .gz")
Instalar paquete de repositorios
> install.packages ("paquete", dependencies=TRUE)
Actualizar paquetes
> update.packages()
> update.packages()
Exportar gráfico generado
Antes de ejecutar el gráfico, debemos dar la instrucción con el tipo de gráfico que queremos guardar:
> jpeg("archivo.jpg")
Después ejecutamos el gráfico, por ejemplo:
> plot(x)
Y por último, para que se guarde el gráfico:
> dev.off()
En vez de jpeg, se puede utilizar png, bmp o tiff.
Y por último, para que se guarde el gráfico:
> dev.off()
En vez de jpeg, se puede utilizar png, bmp o tiff.
lunes, 26 de abril de 2010
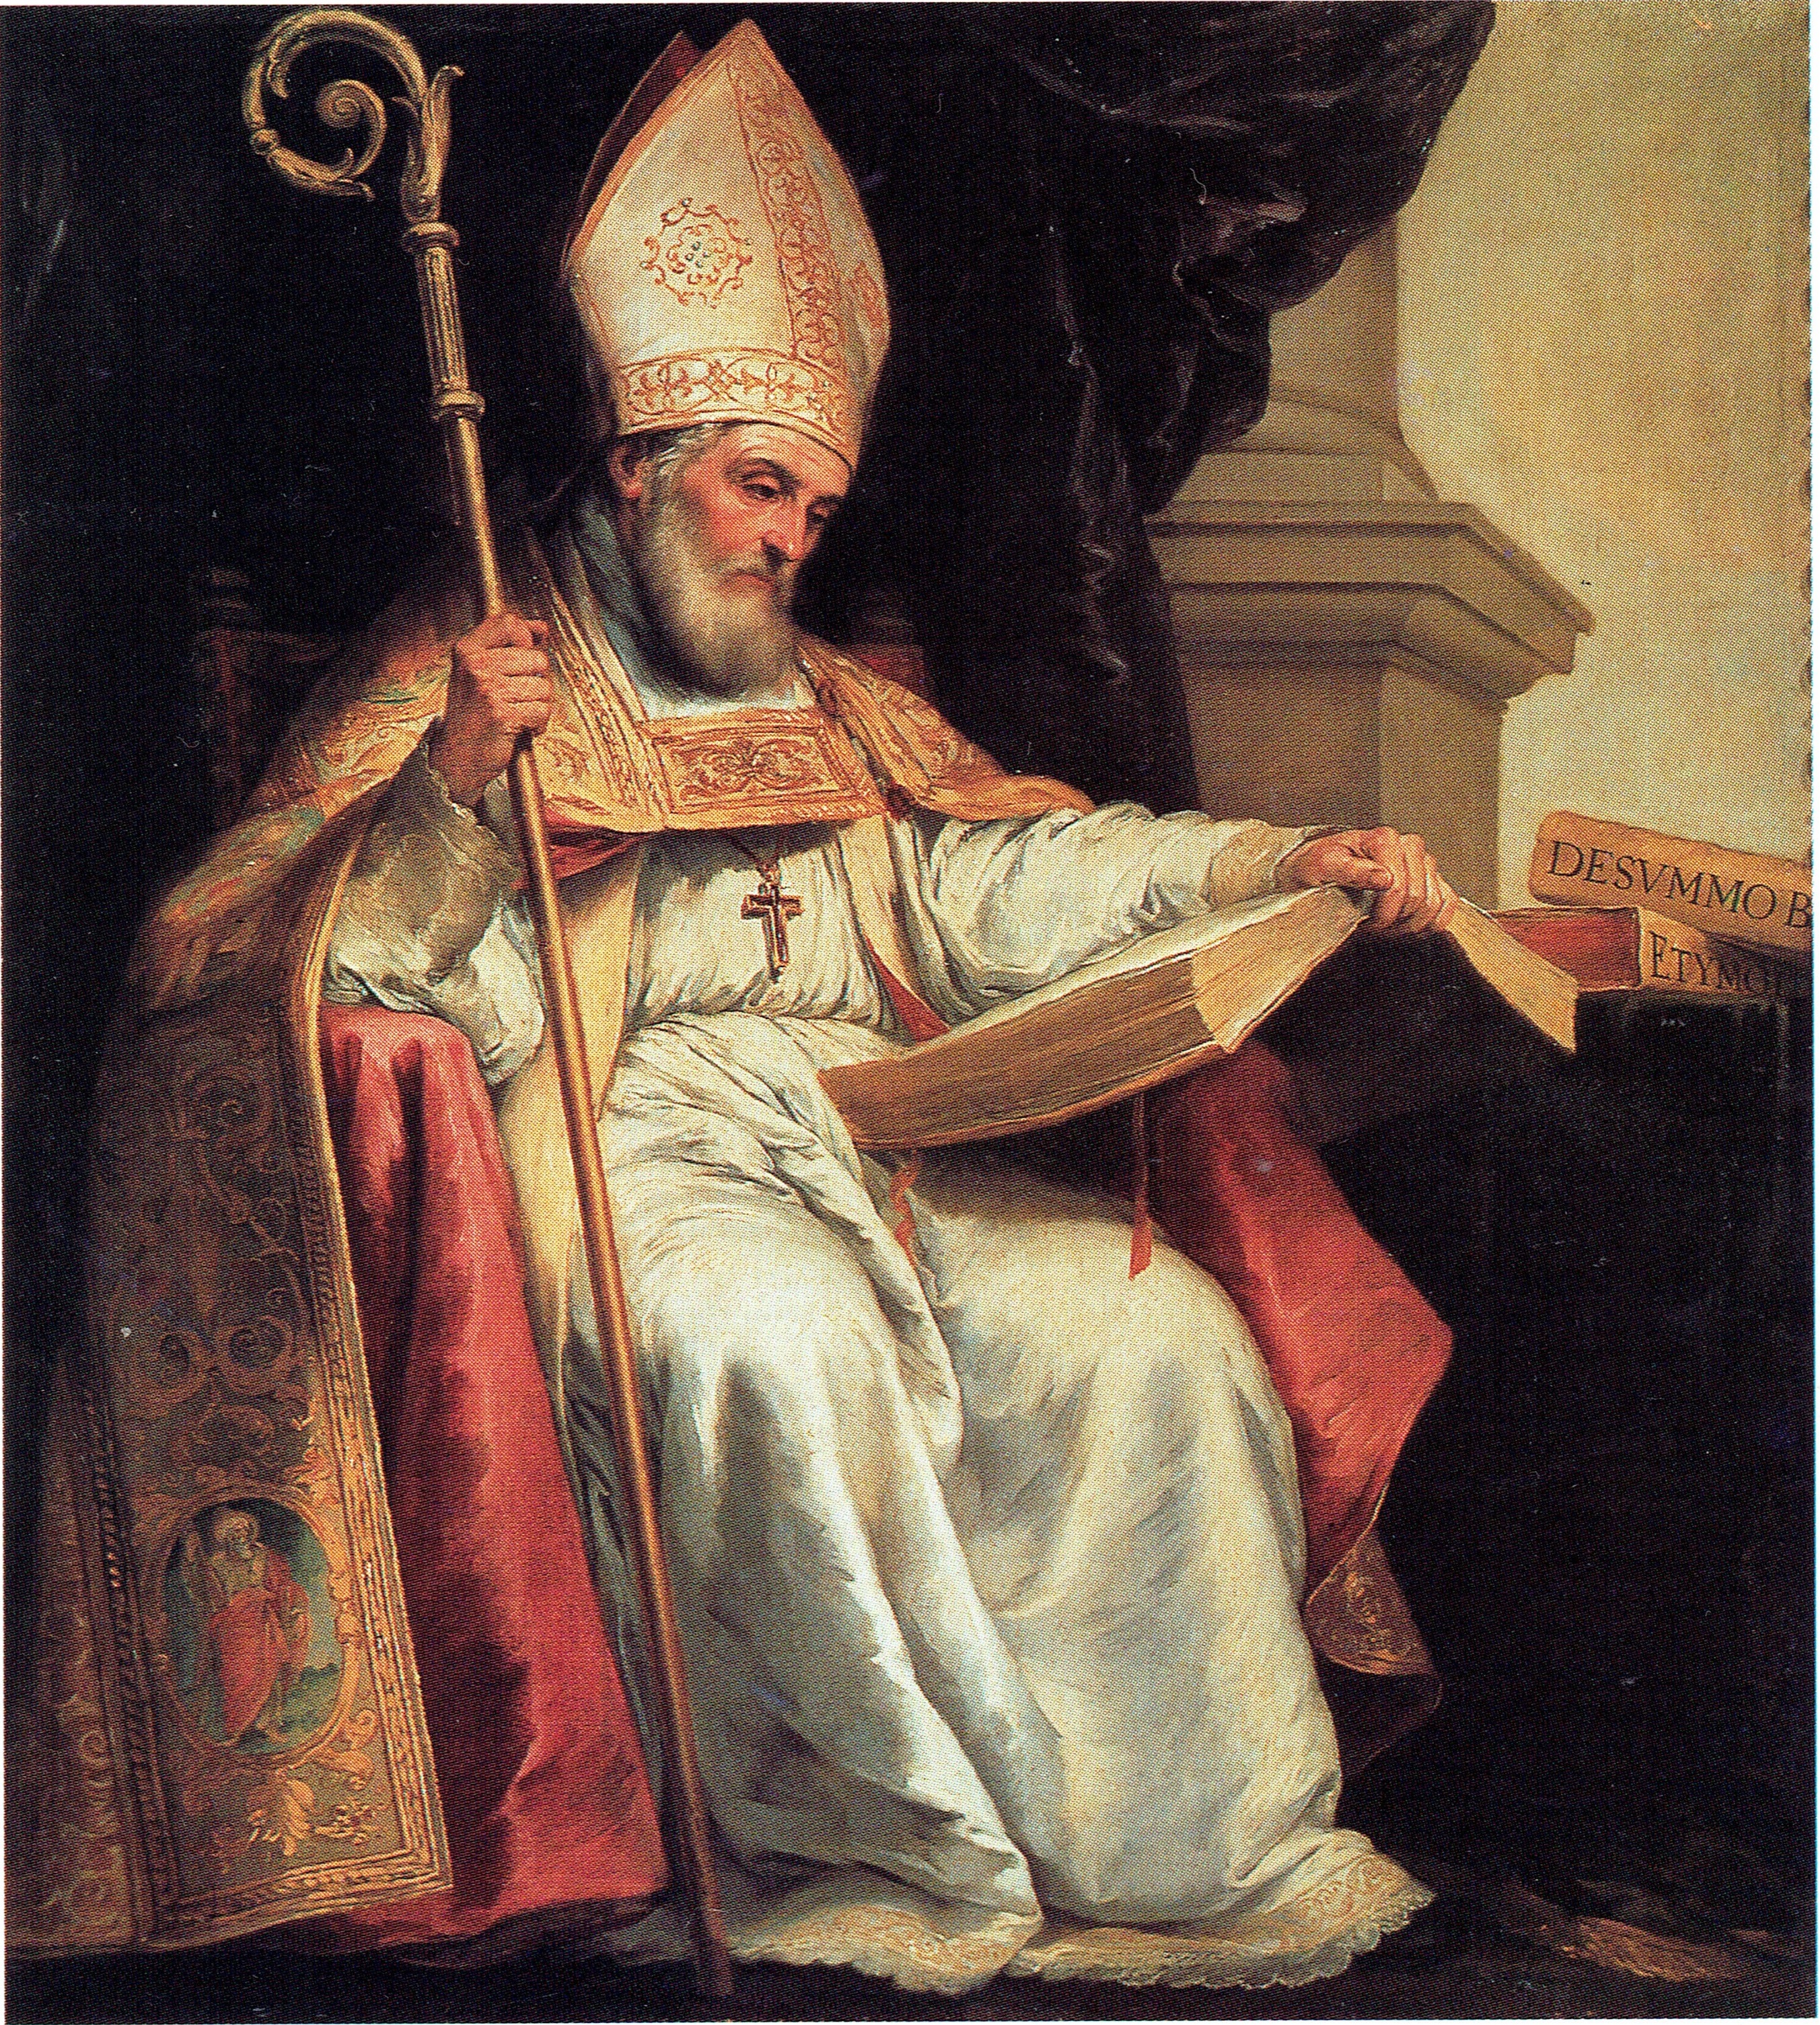
San Isidoro de Sevilla, patrón de Estadística
Ahora que vuelvo a estar en contacto con la Estadística, aprovecho el día del patrón de la Escuela Universitaria de Estadística de la Universidad Complutense de Madrid para conocer más del personaje, y recordar alguna cosa curiosa.
Lo primero que me viene a la cabeza, sin contar que en los tres años de Universidad era un día sin clase, es que posteriormente por motivos de trabajo pasé un día en León. Yo no había estado nunca, pero el compañero de trabajo con el que viajaba sí, y me habló de la colegiata de San Isidoro de Sevilla. Yo le dije "¡Pero si ese es mi patrón!", y nos fuimos a visitar el monumento.
Ya me había advertido mi compañero y amigo Pedro Orihuela que al panteón le llaman "La Capilla Sixtina del Románico", y la verdad es que me encantó. Os aconsejo que visitéis los enlaces a la visita virtual, y si vais a León no dejéis de visitarla.
Era el año 2001, y acababa de celebrarse el año mundial de las Matemáticas. Tuve la ocasión de comprar en el propio museo de la colegiata una edición de su principal obra sobre matemáticas: el libro III de las Etimologías (de Mathematica). El libro incluye la obra en facsímil, y una traducción de Manuel Antonio Marcos-Casquero. Es curioso ver cómo se entendían las matemáticas en la Edad Media, donde no se había avanzado nada desde la época de Pitágoras, y se trataban de explicar las matemáticas desde un punto de vista Divino (por ejemplo para establecer las medidas aproximadas de las estancias del Cielo). En todo caso está considerado uno de los grandes erudidos de la Edad Media.
Yo no voy a escribir más, pero os aconsejo visitar los enlaces que he puesto por el texto. Buceando por la red me han sorprendido dos cosas: la primera, que proponen a San Isidoro como patrón de Internet. La segunda, que en la web de la EU de Estadística no se hace referencia alguna a la festividad.
Lo primero que me viene a la cabeza, sin contar que en los tres años de Universidad era un día sin clase, es que posteriormente por motivos de trabajo pasé un día en León. Yo no había estado nunca, pero el compañero de trabajo con el que viajaba sí, y me habló de la colegiata de San Isidoro de Sevilla. Yo le dije "¡Pero si ese es mi patrón!", y nos fuimos a visitar el monumento.
Ya me había advertido mi compañero y amigo Pedro Orihuela que al panteón le llaman "La Capilla Sixtina del Románico", y la verdad es que me encantó. Os aconsejo que visitéis los enlaces a la visita virtual, y si vais a León no dejéis de visitarla.
Era el año 2001, y acababa de celebrarse el año mundial de las Matemáticas. Tuve la ocasión de comprar en el propio museo de la colegiata una edición de su principal obra sobre matemáticas: el libro III de las Etimologías (de Mathematica). El libro incluye la obra en facsímil, y una traducción de Manuel Antonio Marcos-Casquero. Es curioso ver cómo se entendían las matemáticas en la Edad Media, donde no se había avanzado nada desde la época de Pitágoras, y se trataban de explicar las matemáticas desde un punto de vista Divino (por ejemplo para establecer las medidas aproximadas de las estancias del Cielo). En todo caso está considerado uno de los grandes erudidos de la Edad Media.
Yo no voy a escribir más, pero os aconsejo visitar los enlaces que he puesto por el texto. Buceando por la red me han sorprendido dos cosas: la primera, que proponen a San Isidoro como patrón de Internet. La segunda, que en la web de la EU de Estadística no se hace referencia alguna a la festividad.
Suscribirse a:
Entradas (Atom)